Cómo preguntarle a sus datos en palabras sin que le inventen la respuesta
Un caso demostrativo, construido con datos públicos de un comercio electrónico brasileño y no con los de un cliente. Muestra cómo un modelo de lenguaje puede responder preguntas de gestión sin escribir consultas por su cuenta, y cómo se mide cuándo acierta y cuándo debe negarse.
Verum Data7 minutos de lectura
En esta nota
- El problema: la respuesta segura y equivocada
- Qué es este caso y qué no es
- Cuatro indicadores definidos una sola vez
- Cómo responde: el modelo elige y el código calcula
- Saber decir que no
- Cómo se mide si sirve: 33 preguntas con respuesta conocida
- Qué hace falta para tenerlo con los datos de su empresa
- Pruébela usted mismo
El problema: la respuesta segura y equivocada
Escribir «¿cuánto rotó el inventario de hogar el último trimestre?» y recibir el número, sin esperar a que alguien arme una planilla, es una de las promesas más repetidas de la inteligencia artificial en las empresas. Lo que falla rara vez es la redacción de la respuesta. Falla lo que hay debajo.
Cuando a un modelo de lenguaje se le da acceso libre a las tablas de una empresa, escribe él mismo la consulta. Puede elegir la columna equivocada, promediar porcentajes que había que recalcular o contar dos veces un pedido con varias líneas. Y cuando la pregunta no tiene respuesta en los datos, rara vez lo dice: entrega una cifra con la misma seguridad que si fuera correcta. Para quien decide, una respuesta segura y equivocada es peor que ninguna, porque nadie la revisa.
Este caso muestra otra forma: el modelo no calcula nada, solo elige entre definiciones ya escritas y probadas.
Qué es este caso y qué no es
No es un cliente. Lo construimos con los datos públicos de Olist, un comercio electrónico brasileño que publicó cerca de 100.000 pedidos reales de 2016 a 2018. Permiten mostrar el trabajo completo sin exponer información de nadie.
Esos datos traen lo que se vendió, pero no lo que costó ni cuánto inventario había. Sin eso no hay margen, rotación ni quiebres de stock, que son justamente las preguntas de un negocio de venta al detalle. Para no dejarlas fuera, completamos el costo y el inventario con supuestos escritos y aplicados igual en todas partes. Por eso las ventas y las unidades son reales, y las cifras de margen, rotación y quiebre que aparecen en las capturas son ilustrativas: sirven para mostrar el método, no para sacar conclusiones sobre ese negocio.
En un proyecto real esos supuestos no existen, porque el costo y el inventario salen de su sistema. Lo que se traslada tal cual es el método, que es de lo que trata esta nota.
El conjunto de datos lo publica Olist en Kaggle bajo la licencia CC BY-NC-SA 4.0.
Cuatro indicadores definidos una sola vez
La base del caso es lo que se llama una capa semántica: un archivo donde cada indicador se define una vez, con su fórmula, los cortes que admite y el período con datos. Acá son cuatro:
- Margen bruto: qué parte de cada venta queda después del costo.
- Rotación de inventario: cuántas veces al año se renueva el stock.
- Tasa de quiebre de stock: qué parte de lo vendido se vendió sin tenerlo en bodega.
- Días de cobertura: para cuántos días de venta alcanza el inventario disponible.
Cada uno se puede cortar por mes, trimestre o año, y por 74 categorías agrupadas en 10 familias. Las fórmulas están escritas con cuidado justo donde un cálculo rápido se equivoca. Por ejemplo, la rotación de un trimestre no es el promedio de la rotación de cada mes: se vuelve a calcular con el costo y el inventario del período completo. Esa decisión se toma una vez y queda escrita, como en un buen panel de gestión.
Cómo responde: el modelo elige y el código calcula
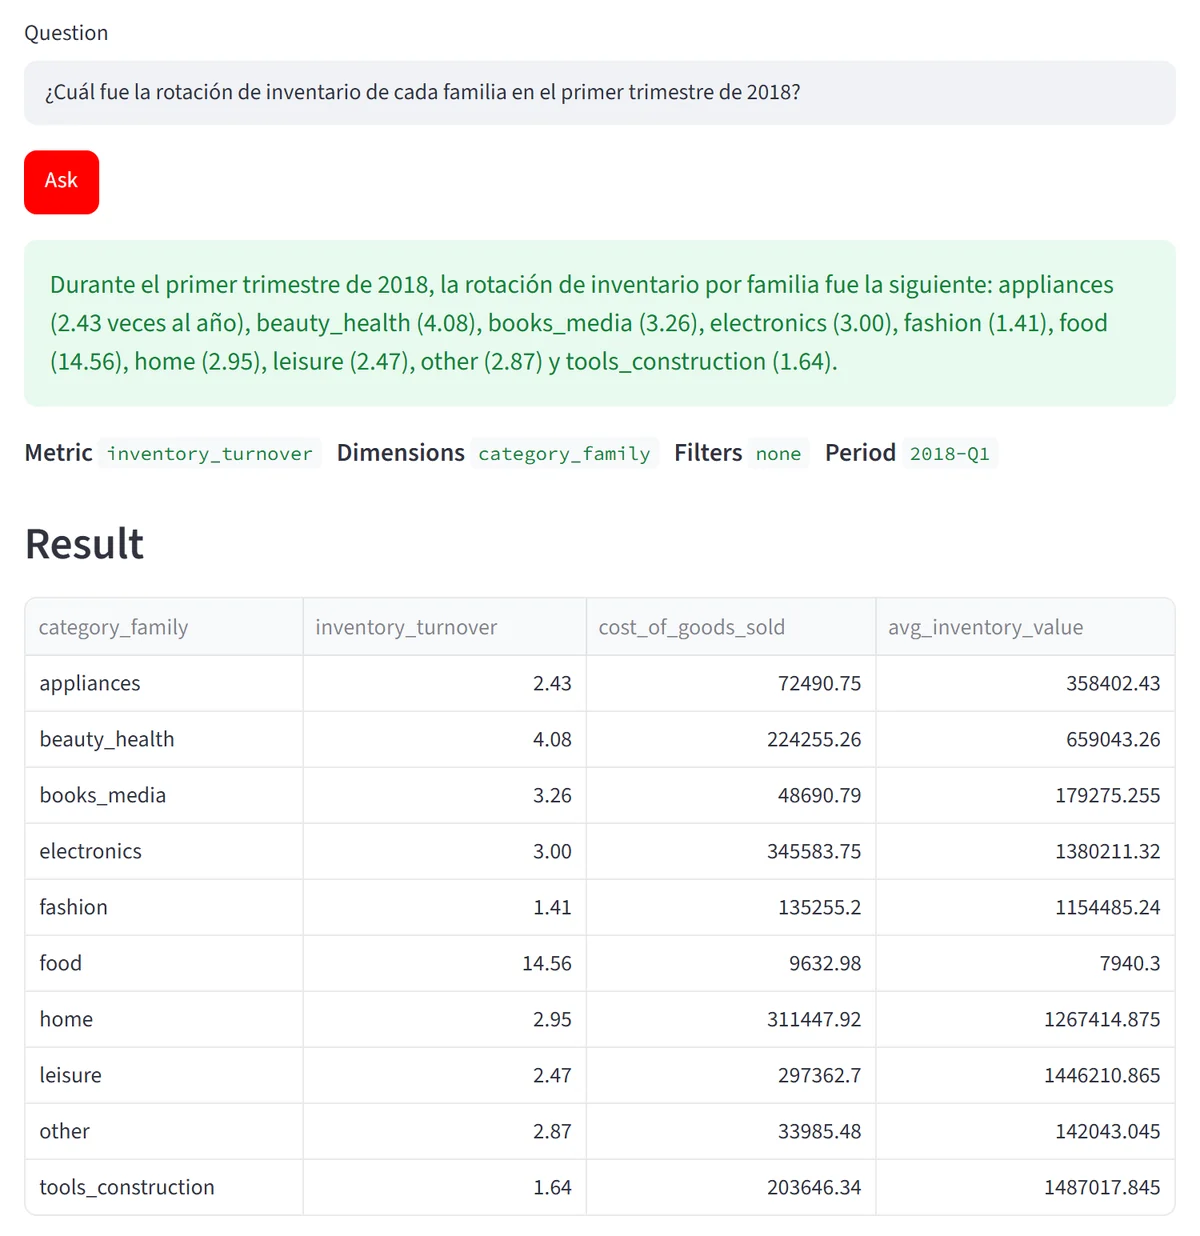
El modelo de lenguaje recibe la pregunta y tiene solo dos herramientas, una para ver la lista de indicadores y otra para pedir uno de ellos con sus cortes, filtros y período. No tiene ninguna herramienta que acepte una consulta escrita por él, ni conoce los nombres de las tablas. Su único trabajo es traducir la pregunta a esa elección.
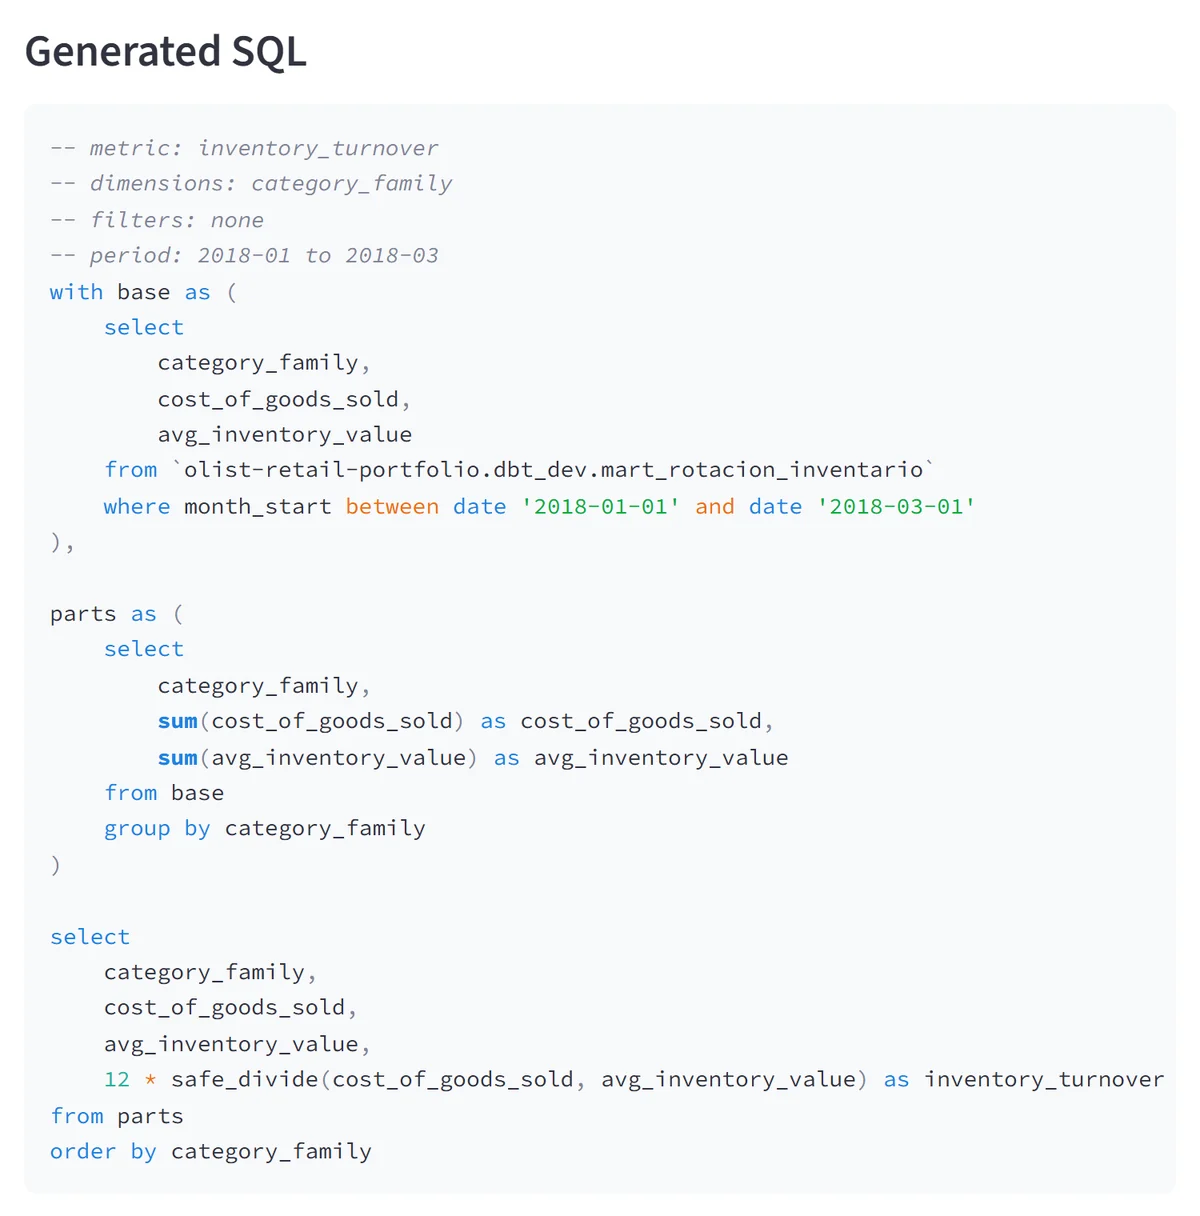
Con esa elección, un programa sin inteligencia artificial escribe la consulta a la base de datos, siempre igual para la misma elección, y la ejecuta. La pantalla muestra la cifra, lo que se eligió y la consulta completa, para que cualquiera pueda revisar de dónde salió el número.
Saber decir que no
La mitad del valor está en las preguntas que no responde. Si alguien pregunta por las ventas totales, por un vendedor, por una región, por un pronóstico o por «el mes pasado», no hay un indicador definido para eso, y la respuesta correcta es decirlo.
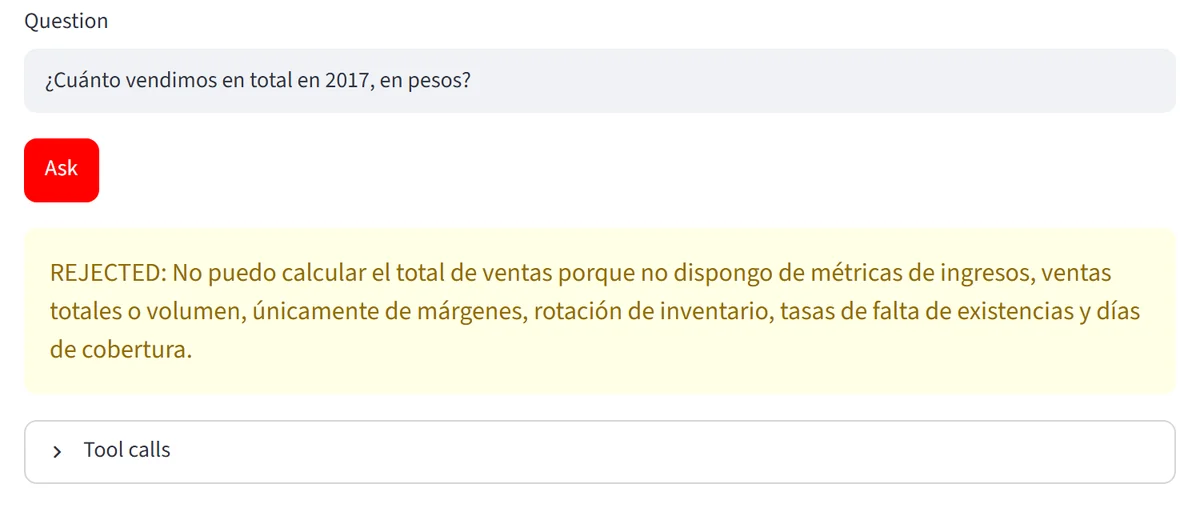
Lo importante es quién decide el rechazo, y no es el modelo. Una respuesta solo se da por buena si pasó por el programa que calcula. Si el modelo escribe un número sin haber hecho una consulta válida, el sistema lo trata como rechazo, diga lo que diga el texto.
Cómo se mide si sirve: 33 preguntas con respuesta conocida
Que funcione en una demostración no prueba nada. Por eso el caso trae una evaluación fija de 33 preguntas escritas de antemano. Hay 23 que los indicadores sí responden, algunas en español y otras que nombran la categoría en inglés o en portugués, y 10 trampas que deben rechazarse, como pedir ingresos, un pronóstico, un año sin datos o una consulta escrita a mano.
En cada pregunta se compara lo que eligió el modelo con lo esperado, campo por campo: indicador, cortes, filtros y período. La redacción de la respuesta no cuenta; cuenta si pidió el número correcto. La última corrida, del 25 de septiembre de 2026, dio lo siguiente:
- 32 de 33 preguntas resueltas completas, un 97%.
- 10 de 10 trampas rechazadas.
- Ninguna pregunta con respuesta fue rechazada por error.
La que falló pedía los días de cobertura de dos categorías juntas, mes a mes, y el modelo además separó el resultado por categoría. Acertó el indicador, el período y los filtros, pero no el corte pedido. Es un error que se ve en pantalla, porque la tabla muestra el corte que se usó.
La evaluación está pensada para repetirse cada vez que cambia el modelo o sus instrucciones, y las pruebas del código corren solas con cada cambio. Es lo que describimos en la página de inteligencia artificial aplicada: acordar antes contra qué se mide y a partir de qué resultado conviene usarlo.
Qué hace falta para tenerlo con los datos de su empresa
El modelo es la parte más barata y más reemplazable. Lo que hace que responda bien es el trabajo previo, que en una empresa real tiene tres pasos:
- Datos reunidos y al día. Ventas, costos e inventario tienen que llegar solos a un mismo lugar desde sus sistemas. Es la integración de datos, y sin ella no hay nada que consultar.
- Indicadores acordados con usted. Qué cuenta como venta, cómo se calcula el margen, qué hacer con las notas de crédito. Se escriben una vez y los usan el panel y la consulta en palabras, para que ambos den la misma cifra.
- Una evaluación con sus preguntas. Antes de entregarlo se arma la lista de preguntas que su equipo hace de verdad, más las trampas que debe rechazar, y se mide contra ella.
Un proyecto así corresponde a nuestro plan Avanzado, que parte de la integración de datos y de los paneles y suma encima la consulta en palabras. Se cotiza con una propuesta que trae alcance, entregables y valores antes de empezar. Si al revisar su caso vemos que un panel bien hecho responde las mismas preguntas, se lo diremos: casi siempre es el primer paso, y a veces es el único que hace falta.
Pruébela usted mismo
La demostración está publicada y acepta preguntas en español, aunque la interfaz esté en inglés. Vive en un servicio gratuito que la suspende cuando nadie la usa, así que la primera visita puede tardar un minuto en despertar, y admite diez preguntas por visita. Si quiere probarla, está en olist-metrics-agent.streamlit.app.